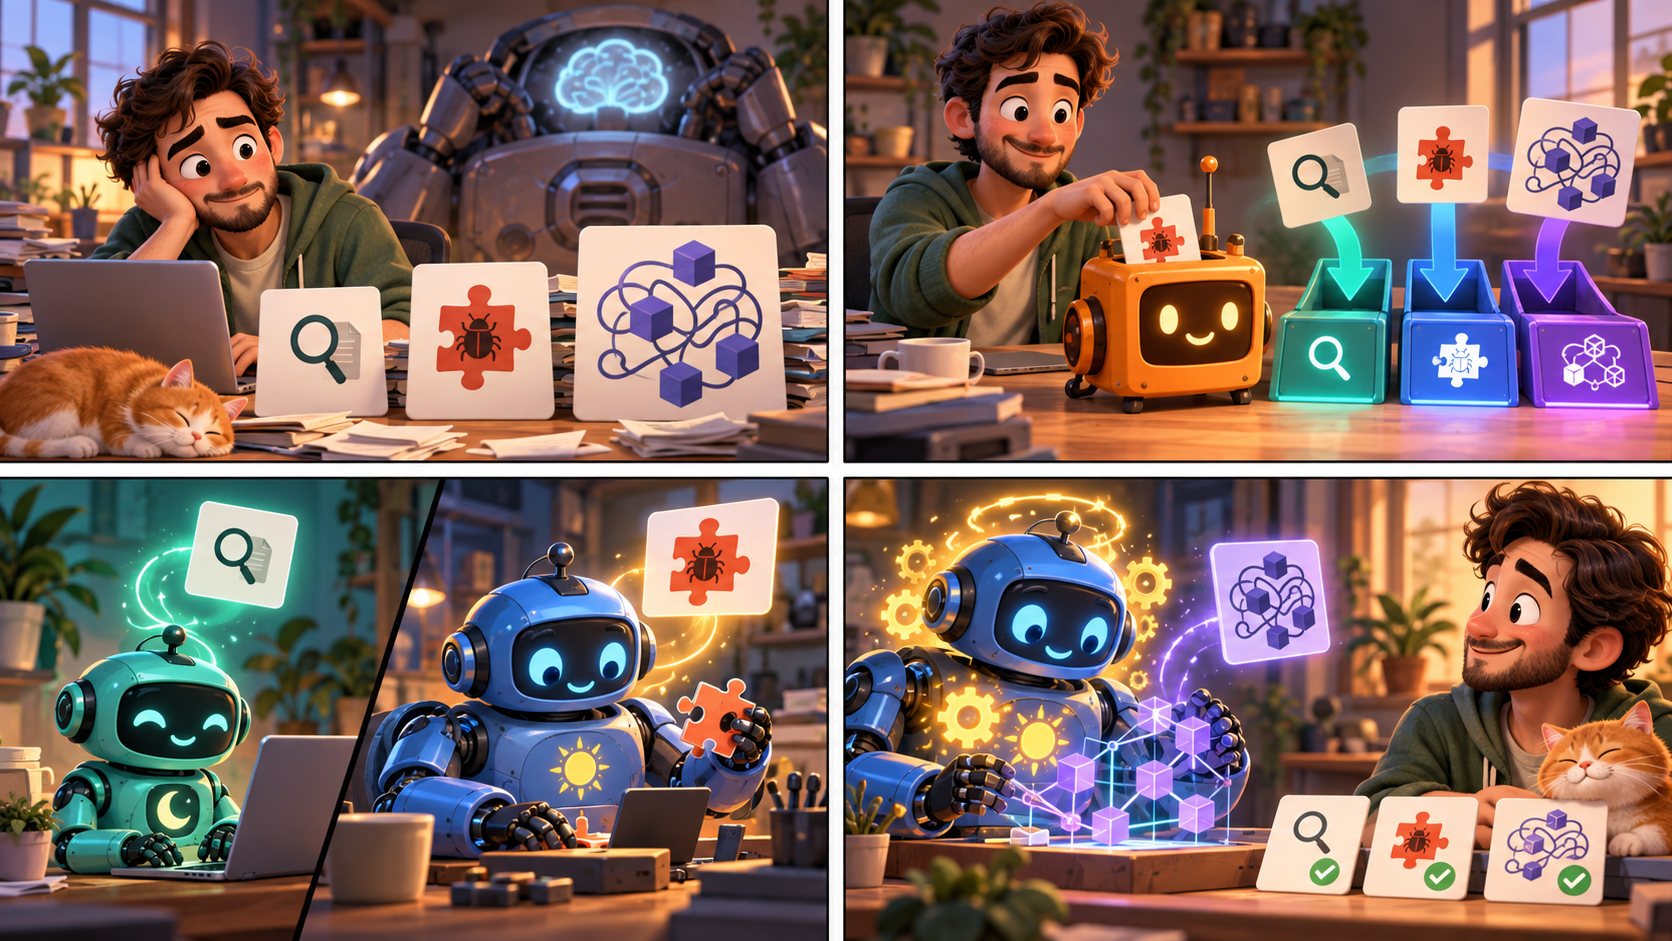
Как я выбираю модели для субагентов Codex
Я часто отправляю субагенту маленькую задачу: найти определение метода, собрать несколько значений из файлов, проверить утверждение по исходникам. Sol high с этим справляется, но запускать ее на каждый такой запрос дорого по тарифам API. Поэтому я добавил перед запуском субагента короткое решение о модели.
Codex Jev Router получает краткое описание поручения и выбирает модель Codex вместе с уровнем рассуждения. Сам агент потом работает обычными инструментами Codex. Роутер не меняет модель посреди задачи и не выбирает инструмент за агента.
Что происходит перед запуском
Родительский агент передает движку решений короткую сводку без исходного кода, логов и секретов. По умолчанию это Jev. Можно подключить локальный движок, например Laya, либо другой поддерживаемый адаптер. Движок возвращает типизированный ответ, а правила роутера проверяют уверенность и выбирают профиль.
Для точного поиска подойдет Luna low; для ограниченной работы в нескольких файлах возможна Luna medium. Короткую задачу, где нужно суждение Sol, можно отдать Sol low. Если решение неуверенное, остается Sol high. Sol ultra предназначена для исключительной сложности или случая, когда Sol уже не справилась. Вызов субагента получает выбранные model и reasoning_effort явно.
Пока это правило в инструкциях Codex, которое родительский агент должен выполнять перед spawn_agent. Я не называю его обязательным перехватом всех запусков: проверка Codex CLI показала, что хук PreToolUse на этом вызове не срабатывает.
Сколько это стоило в проверенных задачах
Для отдельного репозитория бенчмарков я взял реальный снимок Django. Три задачи на чтение исходников запустил по три раза с чистым Sol high и по три раза с выбранным роутером профилем. Во всех девяти парах ответы совпали с фактами из закрепленного коммита. Еще один ограниченный баг из SWE-bench Verified проверил официальным локальным тестом, тоже по три запуска в каждом варианте.
| Задачи | Sol high без роутера | Профиль роутера вместе с Jev | Разница | Проверка |
|---|---|---|---|---|
| Чтение исходников Django, 9 пар | $0.214806 | $0.062317 | 71,0% дешевле | 9/9 правильных ответов в каждом варианте |
| Ограниченное исправление Django, 3 пары | $0.555916 | $0.009668 | 98,3% дешевле | 3/3 прохождения официального теста в каждом варианте |
Это расчет по тарифам Standard API для короткого контекста: отдельно оценены входные, кешированные входные и выходные токены каждой модели. В итог варианта с роутером добавлена стоимость решений Jev. Это не сумма списаний по подписке Codex. Полные трассы, исходные счетчики и формула лежат в отчете.
У исправления есть существенная оговорка. Первый запуск Luna medium был экспериментальным профилем на основе ответа Jev до изменения порога роутера. После изменения порога три повторных решения уже выбирали Luna medium. Полного прогона в Docker-окружении SWE-bench для этого кейса не было; проверялся официальный локальный регрессионный тест.
Что я пока не знаю
Я специально выбрал задачи, где более дешевый профиль имел смысл. Эти числа ничего не говорят о среднем счете на случайном потоке поручений. В отчете есть и контрольные прогоны с одинаковой моделью, где расход менялся сам по себе. На одном старом исправлении pytest обе версии не прошли тест, а вариант с роутером оказался дороже. Такие случаи нельзя прятать за удачным процентом.
Следующий тест я проведу на заранее выбранной смеси реальных задач. В расчет войдут стоимость повторов, ошибок и качество ответов. Пока роутер помогает мне отдавать узкие поручения Luna. Его инструкция по установке и бенчмарк открыты, так что выбор можно проверить на своих задачах.