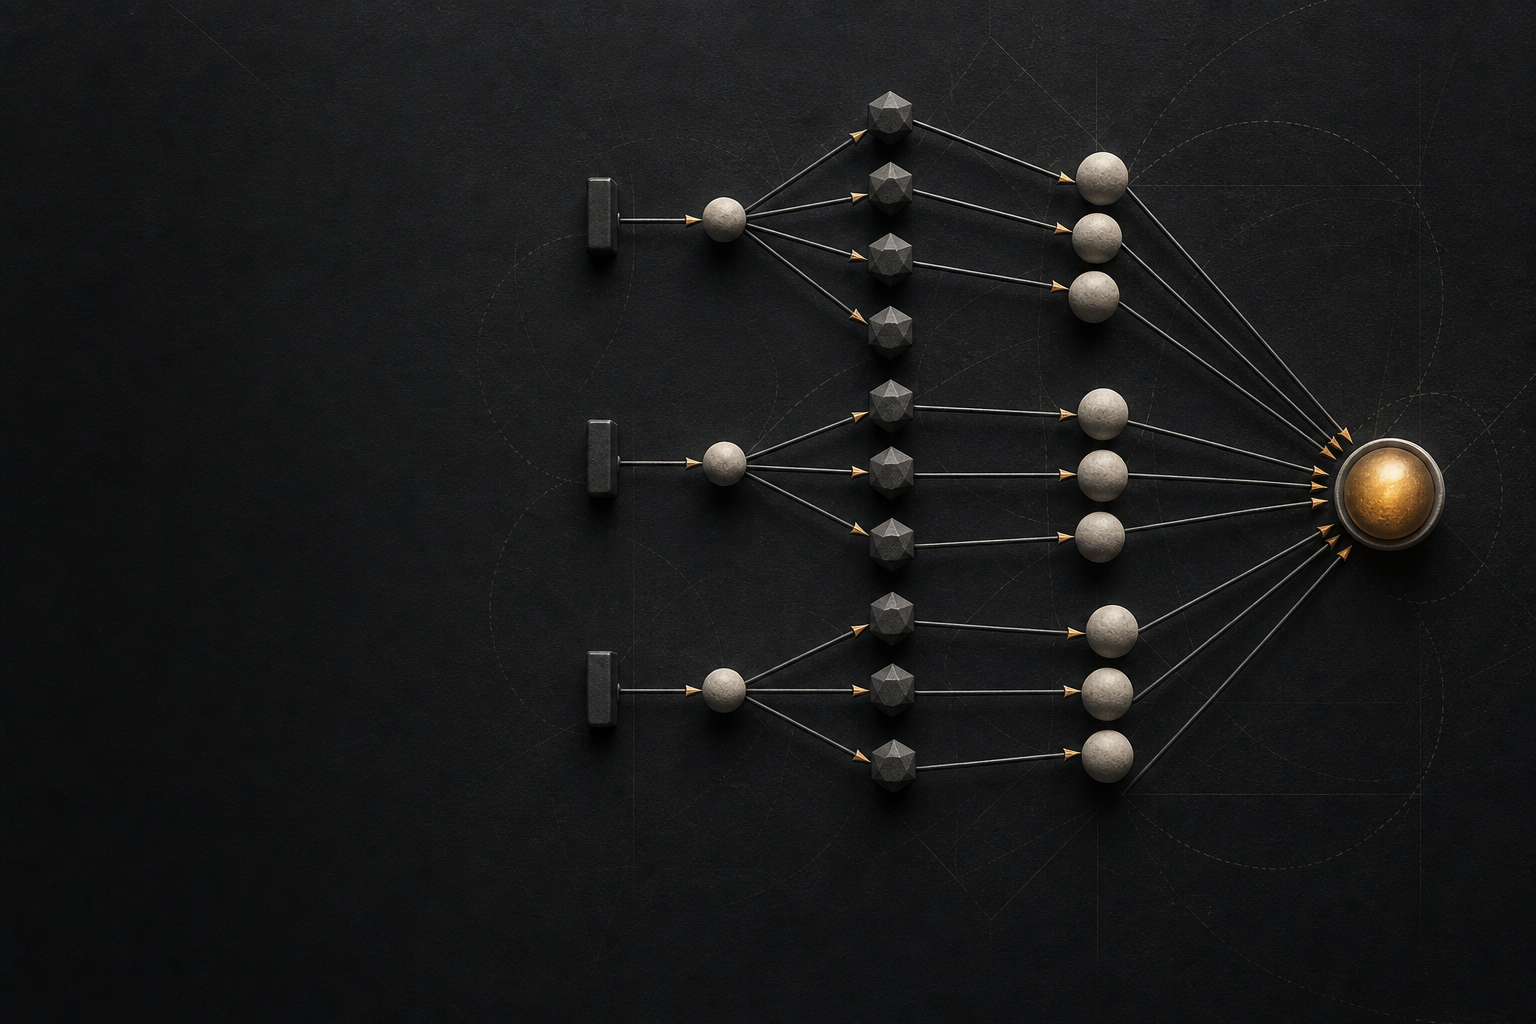
Графовая инженерия мультиагентного ИИ: почему важны связи
Видео на YouTube: Графовая инженерия мультиагентного ИИ
Источник: оригинальное видео на русском
В мультиагентном ИИ-продукте недостаточно заставить одну модель звучать умно. Нужно решить, какой агент увидит какой контекст, какому результату можно доверять и куда дальше попадет каждый артефакт. Это и есть графовая инженерия.
Мосты Эйлера и агенты
Задача Эйлера о семи мостах становится понятнее, если свести карту города к графу: участки суши станут узлами, а мосты станут связями. У мультиагентной системы та же структура. Агенты в ней являются узлами, а сообщения, вызовы инструментов, артефакты и передача на проверку являются связями. В большой системе качество этих связей может быть не менее важным, чем возможности одной модели.
Почему один большой промпт дает сбои
Модель с огромным промптом поначалу кажется простым решением. Затем результаты поиска, заметки, инструкции и незавершенные рассуждения начинают конкурировать за одно окно контекста. Модели приходится решать, что запомнить, пока она еще выполняет саму задачу.
Разделение обязанностей проще контролировать. У каждого агента должны быть узкий системный промпт, чистое окно контекста и одна измеримая задача. Сборщик ищет источники, извлекатель превращает источник в структурированные факты, проверяющий сверяет утверждения, а автор собирает отчет. Оркестратор связывает эти роли, а не заставляет одну перегруженную модель выполнять все сразу.
Исследовательский конвейер как DAG
Полезная архитектура представляет собой направленный ацикличный граф, который движется только вперед:
- Планировщик превращает вопрос в план исследования.
- Сборщики ищут релевантные материалы.
- Извлекатели превращают источники в отдельные доказательства.
- Проверяющие сверяют доказательства, противоречия и ссылки.
- Автор превращает проверенный набор данных в понятный ответ.
В исходном видео приведена иллюстративная схема: 1 планировщик, 5 сборщиков, 25 извлекателей, 75 проверяющих и 1 автор. Там же встречаются другие суммы: 180 и 108, хотя перечисленные этапы дают 107 агентов. Эти числа нельзя считать подтвержденным бенчмарком. Важна форма процесса: работа расширяется для независимого сбора фактов, а затем сужается через проверку перед финальным синтезом.
Изоляция контекста показывает, где ошибка
Узкие промпты помогают не дать лишнему контексту перетекать между этапами. Проверяющему нужны утверждение, фрагменты-основания и правила проверки. Ему не нужны вся история поиска и внутренние рассуждения другого агента. Если итоговый ответ ошибочен, стоит проверить конкретную передачу: вернул ли сборщик слабый источник, потерял ли извлекатель важное уточнение, получил ли проверяющий нужные данные?
Это может сделать повторные запуски дешевле. Неудачный извлекатель можно перезапустить, не повторяя весь отчет, а у каждого артефакта могут быть понятные родители и потомки.
Кэширование промптов сокращает повторные расходы
Сети агентов часто используют одни и те же системные инструкции. Если десятки проверяющих получают длинный неизменный префикс, его кэширование может сократить повторную обработку входных токенов. В видео заявлено снижение примерно с 10 до 1 доллара за запуск. Это иллюстрация из источника, а не независимо подтвержденный бенчмарк. Сам подход полезен: отделяйте постоянные инструкции от данных задачи, кэшируйте повторяемое и измеряйте расходы там, где они возникают.
Трудность в связях между агентами
Многие современные агенты умеют читать код, работать с браузером, вызывать инструменты, анализировать ошибки и повторять попытки. Сложнее правильно соединить их работу: определить, что агент знает, что производит и куда дальше попадет его артефакт.
К графу стоит относиться как к рабочей системе: задавать типы входов и выходов, хранить происхождение данных, добавлять тайм-ауты и лимиты повторов, делать каждую передачу наблюдаемой. Циклы в исследовательском пути лучше не допускать, если только для них не нужен отдельный этап проверки. Тестировать стоит весь граф на сложных входных данных, а не только отдельные узлы. Способная модель полезна, но надежный ИИ-продукт также требует надежных связей между агентами.